ClarixAI
Egy rossz feleletválasztós válasz semmit sem árul el a mögötte húzódó gondolatmenetről. Olyan elemzőrendszert építettünk, amely végigolvassa a szabad szöveges válaszokat, és megmutatja a tanárnak, milyen tévhitek határozzák meg az osztály gondolkodását.
- Év
- 2026
- Terület
- Mesterséges intelligencia · Web · Egyedi szoftver
- 3
- Nyelv: NL, EN, HU
- 8
- Tévhitkategória
- 4-ckpt
- Ensemble: éles NL-modell
- HDBSCAN
- Kérdéseken átívelő klaszterezés
A projektről
A ClarixAI a holland, angol és magyar nyelvű szabad szöveges diákválaszokat nyelvenkénti transzformer-ensemble modellekkel (RobBERT-2023, RoBERTa-base, huBERT) dolgozza fel, nyolc tévhitkategóriát lefedő, 1-vs-rest szigmoid kimeneti réteggel. Az enkóder-beágyazásokon futó HDBSCAN-klaszterezés feltárja a kérdéseken átívelő strukturális mintázatokat, a vezérlőpult pedig minden címkét „mit jelent (miért alakul ki) mit tehet a tanár” felépítésű módszertani kártyává alakít. Stúdiónk szállította a betanítási csővezetéket, az inferenciaszolgáltatást és a tanári felületet.
A ClarixAI elemzi a diákok szabad szöveges válaszait (holland, angol és magyar nyelven), és feltárja az osztályban leggyakrabban előforduló tévhitmintázatokat (például a fogalomkeverést, a felszíni mintázatkövetést, a hiányzó előismeretet és hat további hibakategóriát), mindegyikhez konkrét pedagógiai cselekvési kártyát rendelve. A rendszer nem a diákokat osztályozza, hanem a csoport gondolkodási folyamatait térképezi fel. Nyelvenkénti többfeladatos transzformer-ensemble és HDBSCAN-klaszterezés azonosítja a feladatokon átívelő strukturális összefüggéseket.
01Kihívás
- A feleletválasztós teszt csak annyit mutat meg, hogy a válasz hibás: azt nem, hogy miért
- A szabad szöveges válaszok mintázatainak kézi kiszűrésére a tanároknak nincs idejük
- Ha a tanár nem látja a mögöttes okot, a „gyakorolj még” marad az egyetlen visszajelzés
02Amit építettünk
- Többfeladatos tévhitosztályozó modell: holland, angol és magyar nyelven
- 8 gondolkodásihiba-kategória, mindegyikhez közvetlen tanári javaslattal
- HDBSCAN-klaszterezés a feladatokon átívelő strukturális mintázatok feltárására
- Évfolyam- és csoporttrendeket bemutató tanári vezérlőpult
- Pedagógiai tudástár: mit jelent a hiba, miért alakul ki, és hogyan érdemes kezelni
→Eredmény
- Feladatonként láthatóvá válnak az osztályt jellemző domináns gondolkodási hibák
- Minden hibamintázathoz azonnal alkalmazható tanári módszertani javaslat társul
- A csoportok közötti trendek világosan kirajzolják a tantervi hiányosságokat
03Így készült
- 01 · BRIEF
Az elemzés tárgya maga a válasz mögötti gondolatmenet, nem pusztán a végeredmény.
A termék legfontosabb alapelve, hogy a rendszer soha nem osztályozza az egyes diákokat. Ehelyett az osztályban megjelenő közös tévhiteket teszi láthatóvá, így a tanár pontosan látja, melyik témakört kell újra elmagyaráznia, és milyen megközelítésből.
- 02 · BUILD
Nyelvenkénti transzformerek, túlillesztés elleni betanítás és éles ensemble-architektúra.
A holland nyelvhez RobBERT-2023, az angolhoz RoBERTa-base, a magyarhoz pedig huBERT modellt használtunk, a v5.0-s túlillesztés elleni eljárással betanítva (befagyasztott alsó rétegek, focal loss, SupCon és súlyozott aranyhalmaz). A holland éles környezet 4 ellenőrzőpontos ensemble-ként (v6.2) fut, címkénként korlátozott döntési küszöbökkel és k-NN prototípus-keveréssel; az angol modell F1-értékben hozza a holland szintjét, ellenpéldákon (adversarial argmax) pedig felül is múlja azt.
- 03 · SHIP
FastAPI-alapú inferencia és Vite/React tanári vezérlőpult három nyelven élesítve.
Az inferenciaszolgáltatás feladatonként klaszterezi a válaszokat az enkóder-beágyazásokon futó HDBSCAN segítségével, kiemeli a kérdéseken átívelő strukturális mintázatokat és csoporttrendeket, majd összekapcsolja őket a pedagógiai tudásbázissal, amely minden címkét konkrét tanári cselekvési kártyává alakít.
04Eredmény · amit szállítottunk
- 01 · Modell
Nyelvenkénti ensemble: 8 tévhitkategória
RobBERT, RoBERTa és huBERT modellek 1-vs-rest szigmoid kimenettel, fogalomkeverés, felszíni mintázatkövetés, hiányzó előfeltétel és öt további kategória.
- 02 · Adatfeldolgozás
Osztályozás → klaszterezés → trendelemzés
Válaszonkénti osztályozás, kérdésenkénti HDBSCAN-klaszterezés az enkóder-beágyazásokon, majd a feladatokon átívelő és csoportszintű mintázatok összesítése.
- 03 · Vezérlőpult
Feladatonkénti elemzés és csoporttrendek
Háromnyelvű (NL / HU / EN) Vite és React felület, ahol a tanárok egymás mellett látják az egyes kérdések tévhitsűrűségét és az évfolyamokon átívelő trendeket.
- 04 · Módszertan
Cselekvési kártya minden tévhitkategóriához
Minden címke egy „mit jelent (miért alakul ki) mit tegyél” felépítésű módszertani kártyához kapcsolódik: a rendszer feltárja a mintázatot, a kártya pedig megadja a pedagógiai választ.
05Technológia
- Python
- PyTorch
- Transformers
- FastAPI
- React
06Képernyők
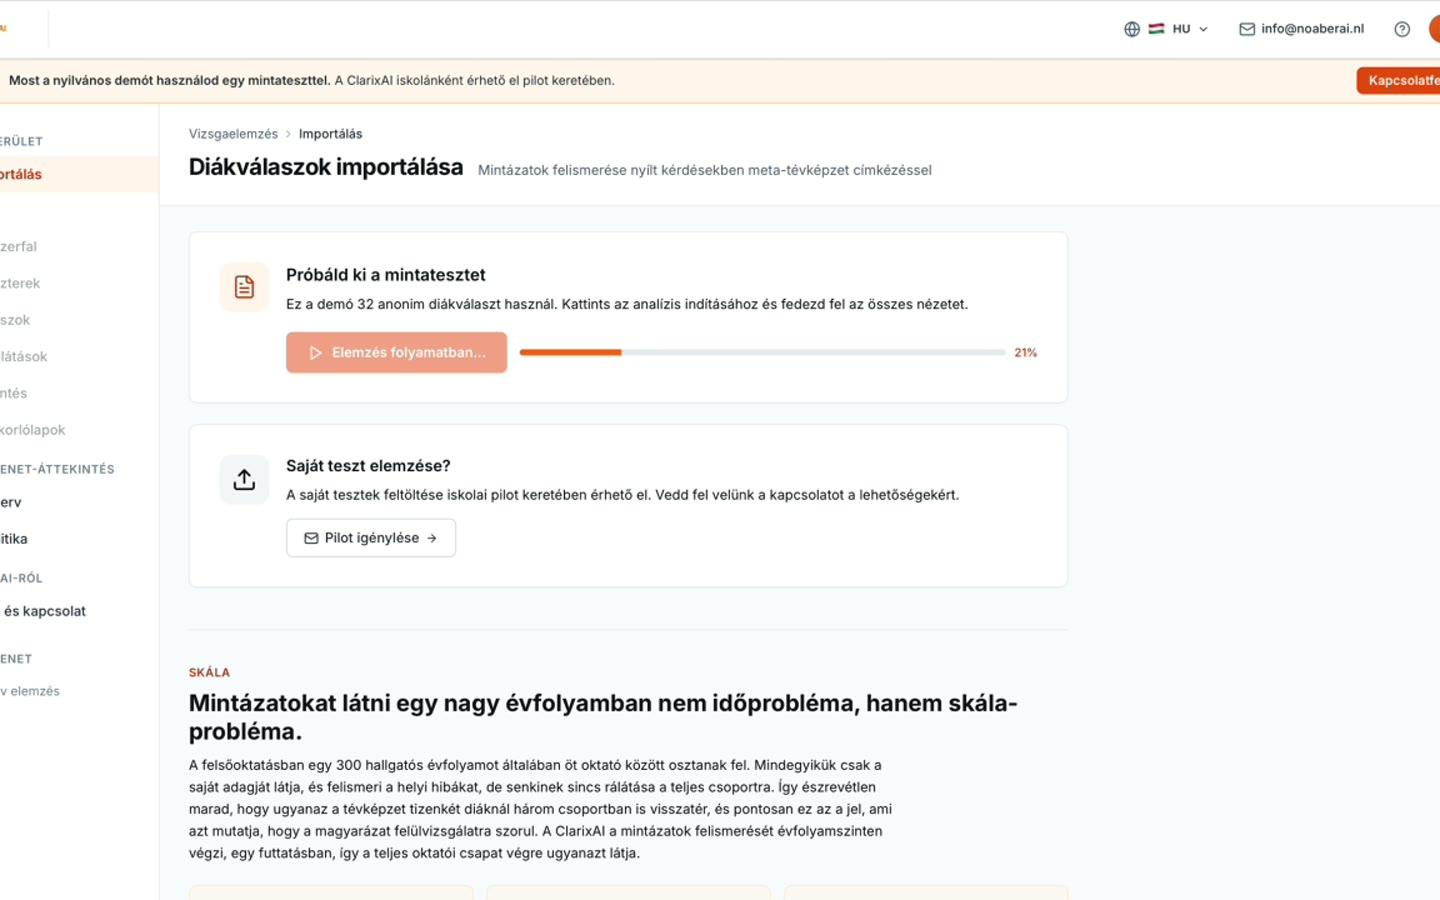
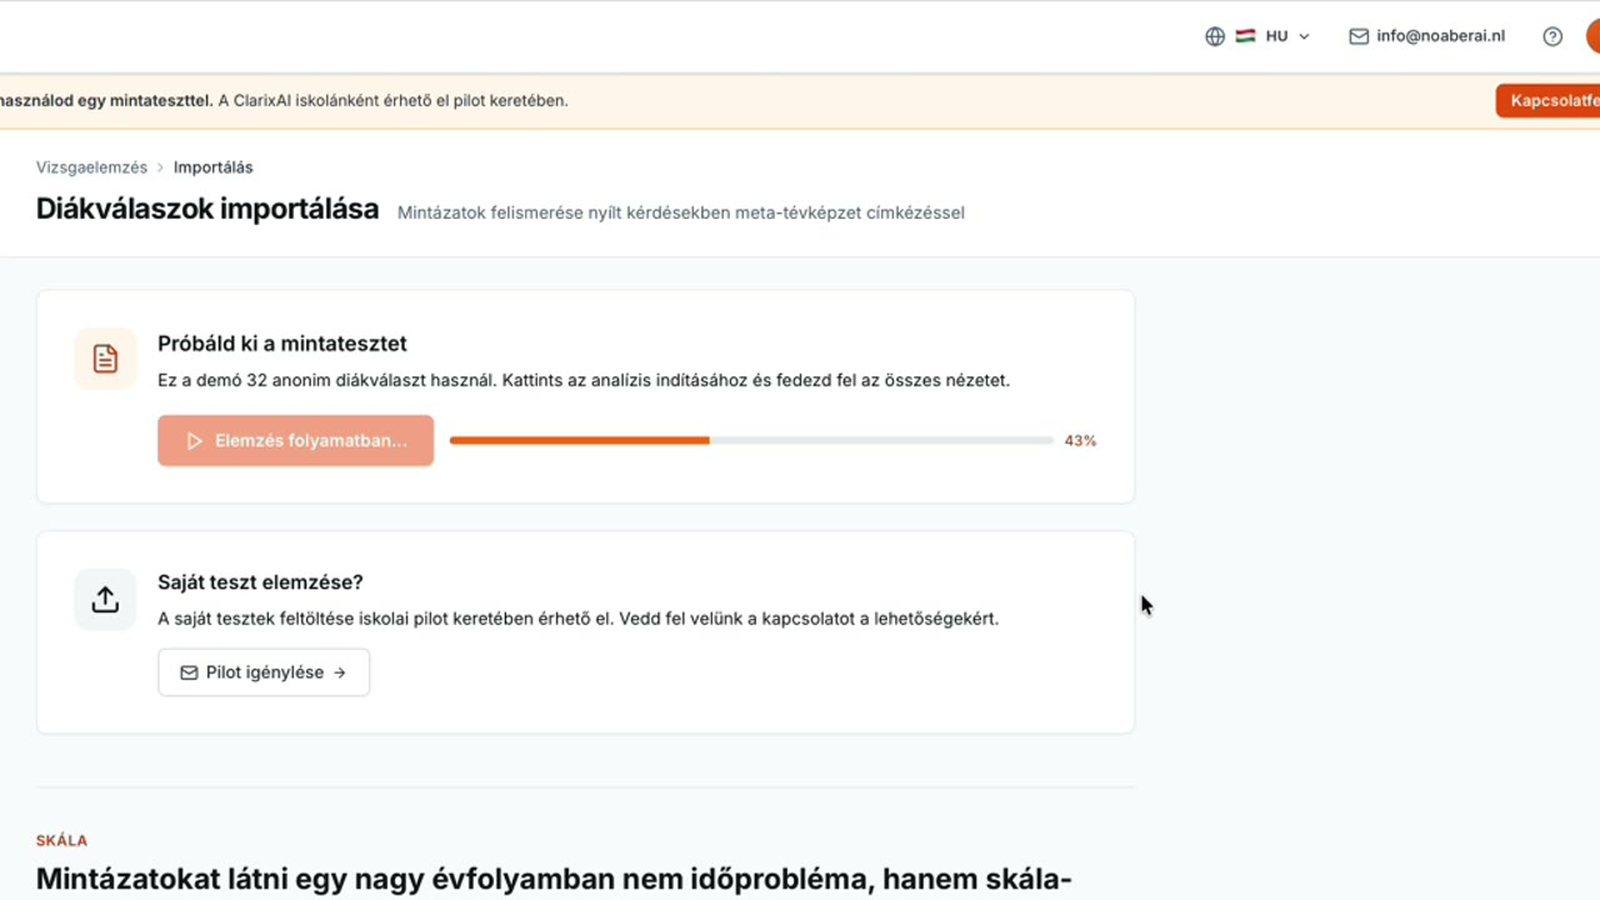
A tanár kérdésenként látja, mely tévhitkategóriák jellemzik az adott csoportot, nem azt, hogy ki hibázott, hanem azt, milyen gondolkodási minta húzódik a válaszok mögött.
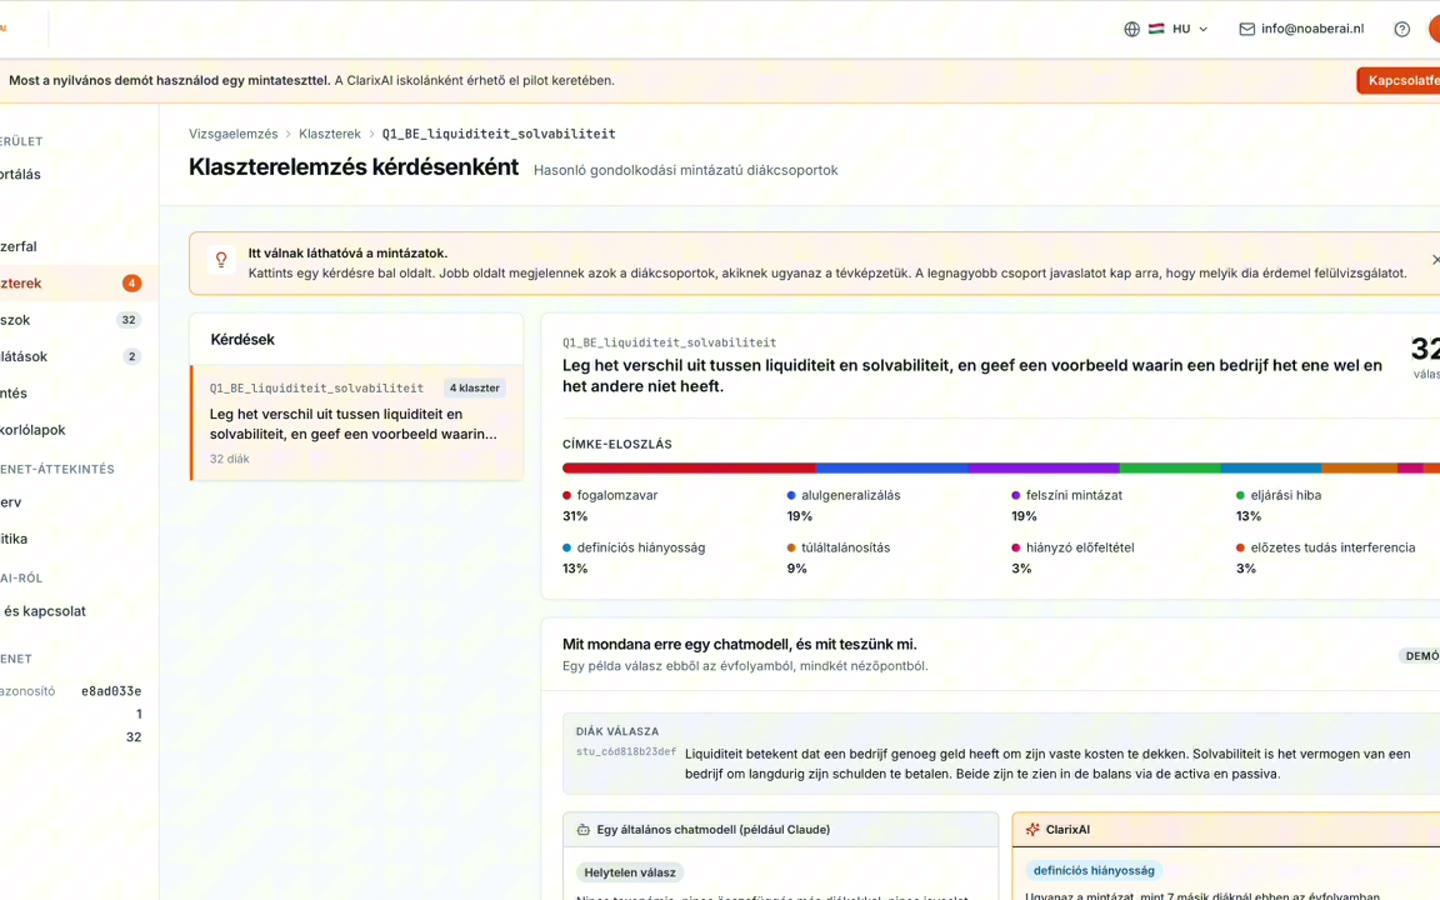
A címkénként korlátozott döntési küszöbök tisztán tartják az elemzést: egy bizonytalan megfogalmazású válasz nem aktiválja egyszerre az összes kategóriát, így valóban a meghatározó hiba marad fókuszban.
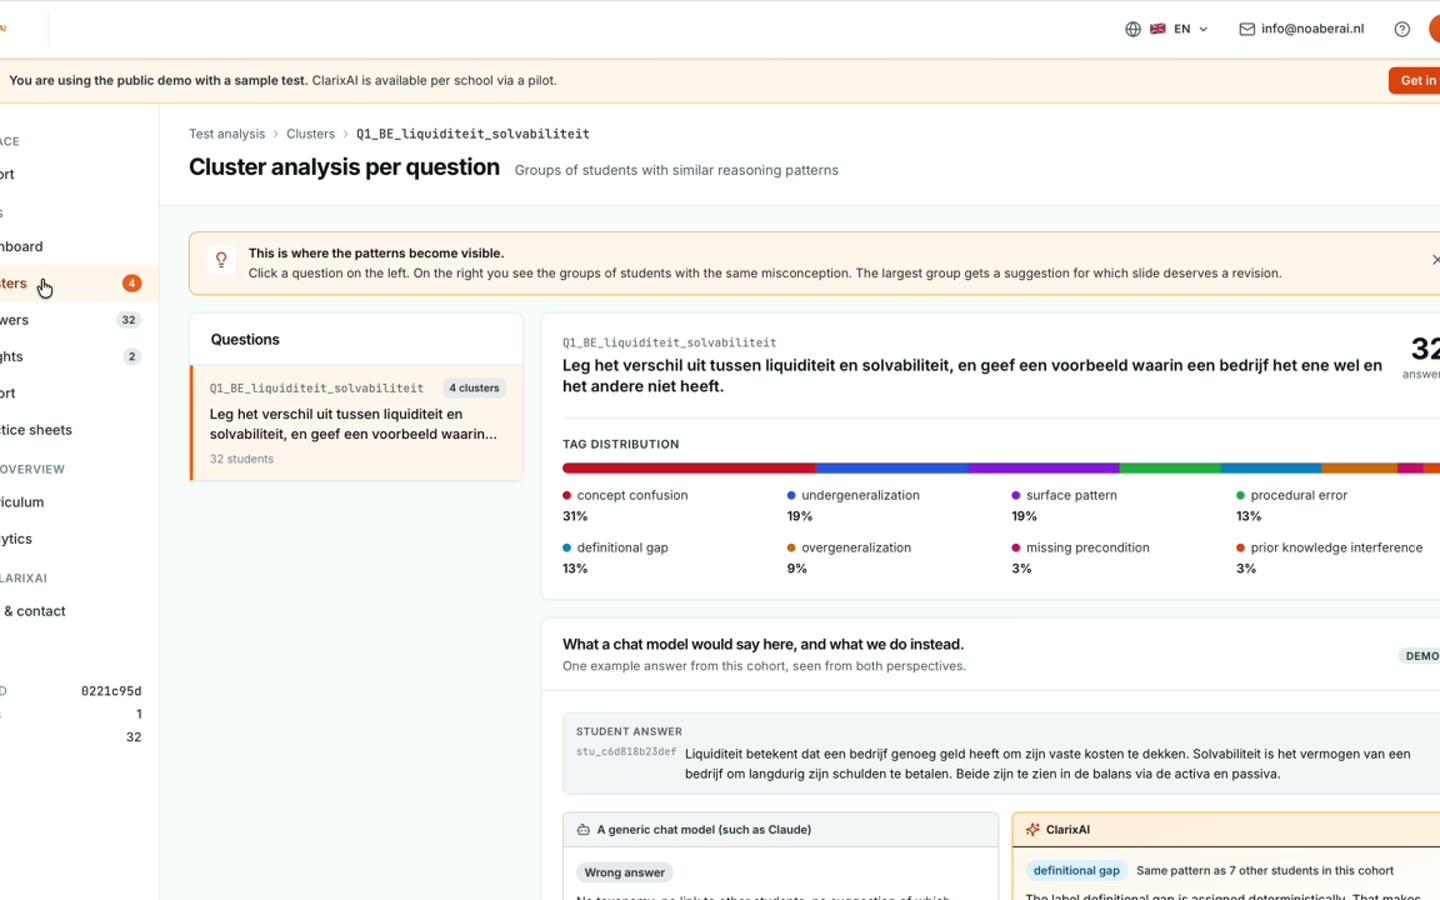
Az enkóder-beágyazásokon futó HDBSCAN megtalálja azokat a tévhiteket is, amelyek különböző témájú kérdéseknél térnek vissza, ez az a tantervi szintű jelzés, amely egy-egy feladat külön vizsgálatakor rejtve maradna.
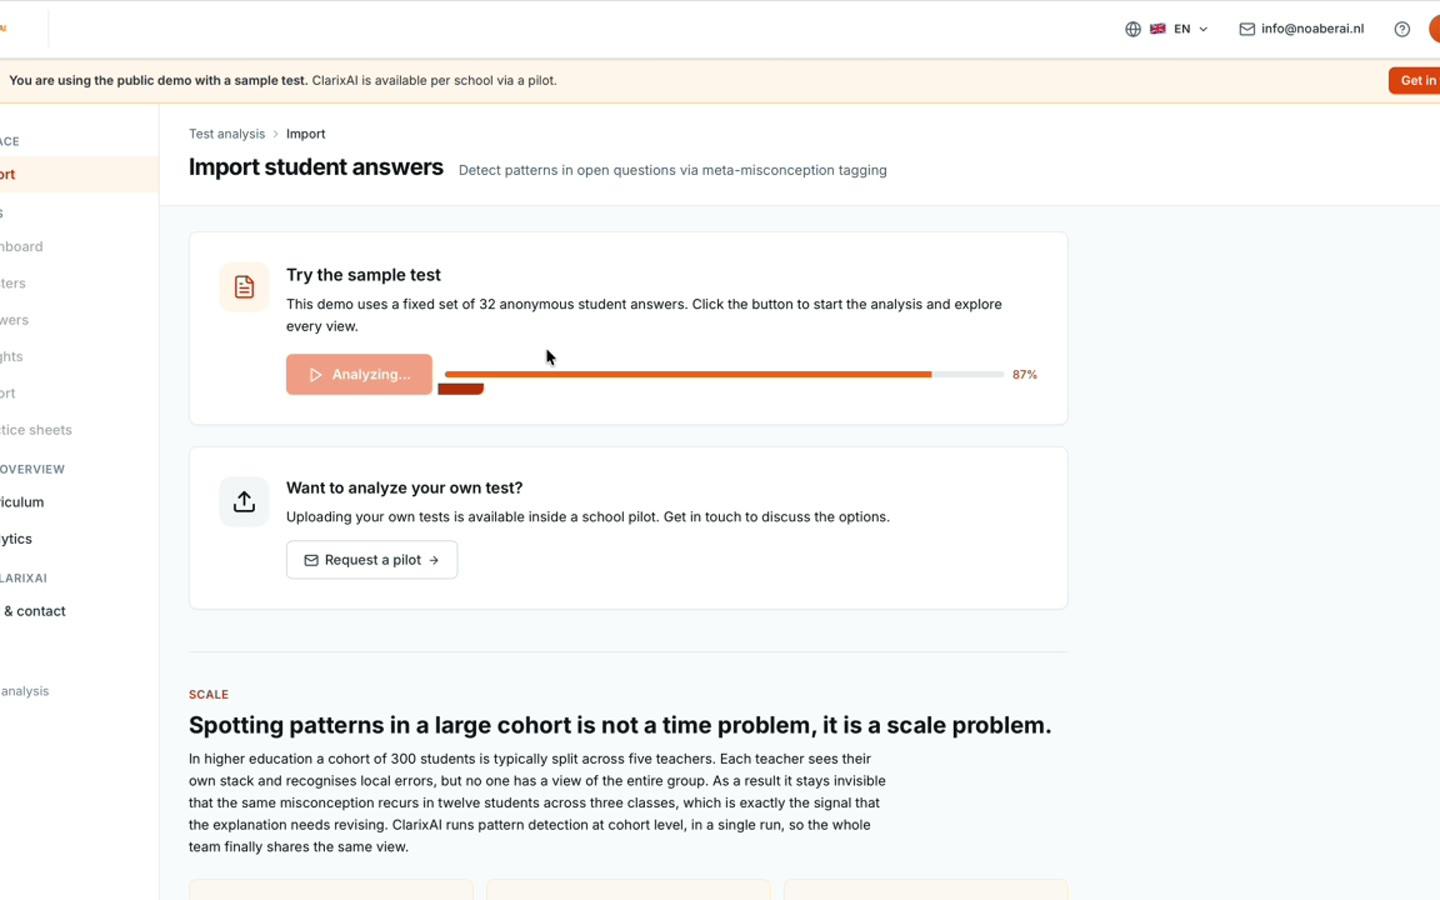
A csoportokon átívelő trendek egyértelműen megmutatják a tantervi hiányosságokat: ha ugyanaz a tévhit három egymást követő osztályban is dominál, akkor a tananyag felépítésén kell változtatni, nem a gyakorlófeladatok számán.
A munkák egy része még korábbi nevünkön, DField Solutionsként készült (a névváltásra azért került sor, mert a DField Solutions önálló, saját termékünkké vált).
Hasonlót építene?
Beszéljünk→